有个场景在机房反复上演:新采购的一批“高性能”网卡装上去,业务吞吐没有任何起色;同一型号插到另一台机器上,却“焕发青春”。运维的第一反应往往是“卡有问题”,但多数时候,网卡是被冤枉的。
先纠正一个归因习惯:硬件常常是“背锅侠”
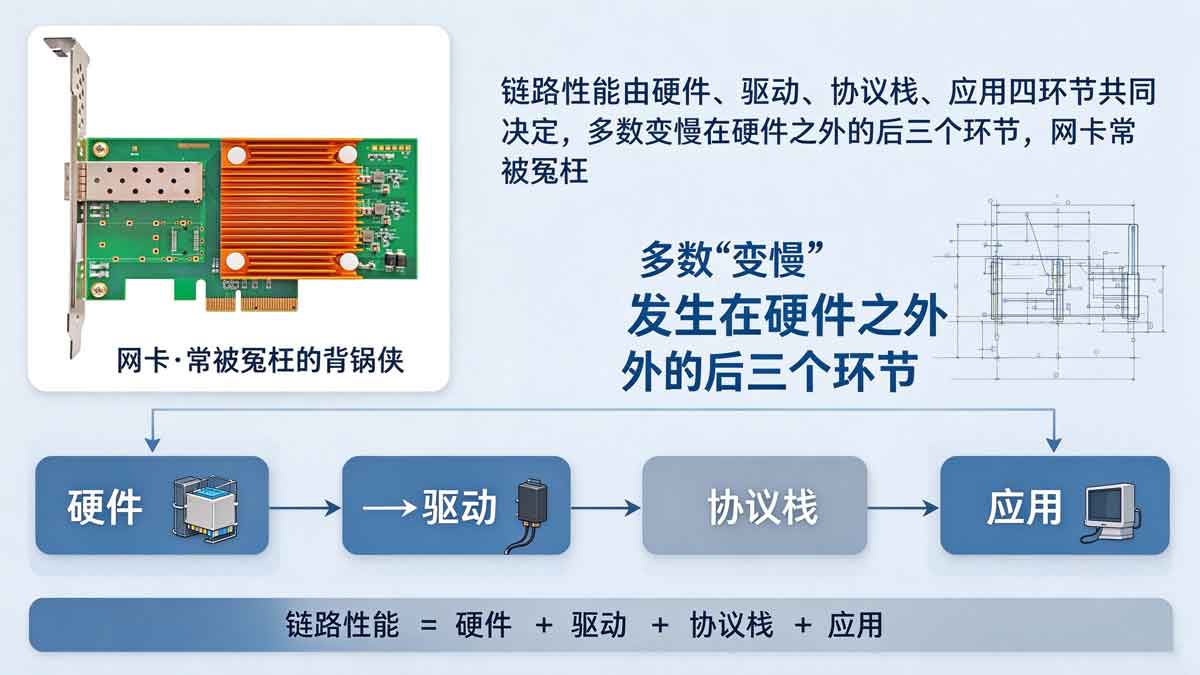
一条链路的性能由四个环节共同决定:硬件、驱动、协议栈、应用。绝大多数“变慢”发生在硬件之外的后三个环节。网卡厂商能控制的是硬件与驱动,剩下的交给操作系统和运维——可很多团队把全部期望压在“换一块好卡”上,配置却还停留在出厂默认值,等于让新硬件跑旧配置。
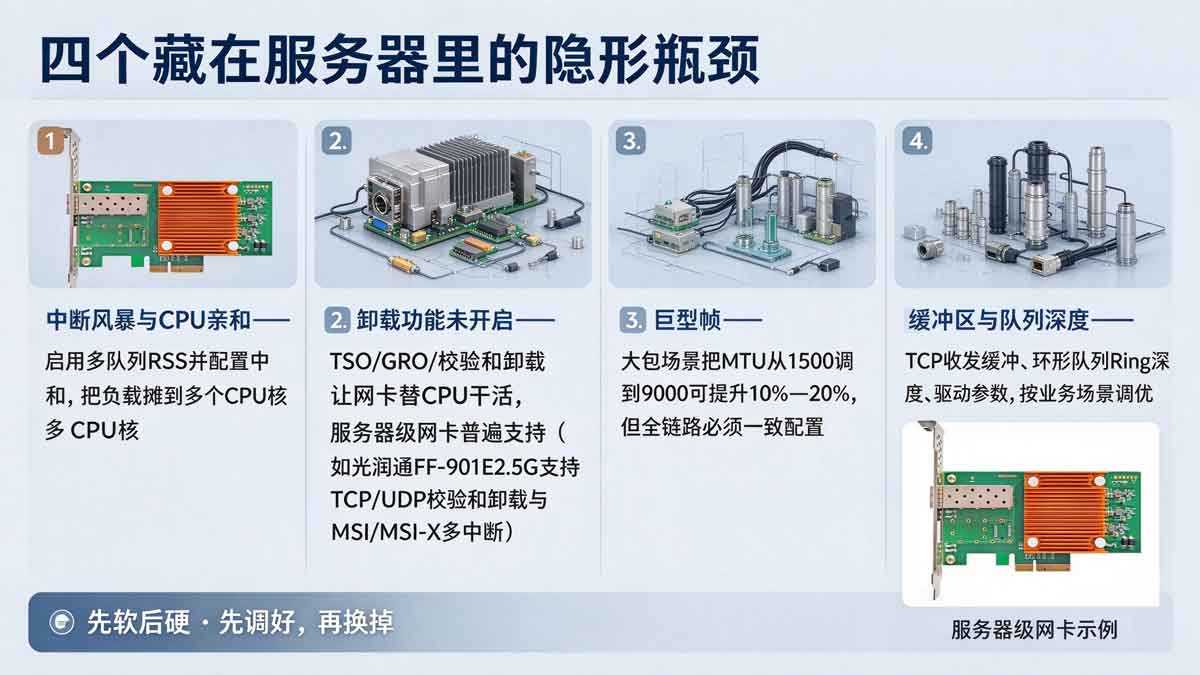
四个藏在服务器里的隐形瓶颈
第一个是中断风暴与CPU亲和。默认驱动可能把全部中断打进同一个CPU核,出现“某个核满载、网卡却空闲”的假性瓶颈。启用多队列(RSS)并配置中断亲和,把负载摊到多个核上,往往立竿见影。
第二个是卸载功能没有开启。TSO、GRO、校验和卸载这类硬件加速,本质是让网卡替CPU干活。不开卸载,CPU就要用软件去分段、校验、重组,吞吐与CPU占用此消彼长。服务器级网卡普遍支持这些特性——例如光润通FF-901E2.5G支持TCP/UDP校验和卸载与MSI/MSIX多中断——但“支持”不等于“已启用”,需要运维去确认。
第三个是巨型帧。虚拟化、存储、备份等大包场景,把MTU从1500调到9000往往能带来10%—20%的吞吐提升;但全链路必须一致配置,否则反而增加分片与丢包。
第四个是缓冲区与队列深度。TCP收发缓冲区、环形队列(Ring)深度、驱动参数,默认值面向“通用”而不是“你的场景”。这一层最容易被忽视,也最值得按业务调优。
“先软后硬”的五步排障清单
遇到网络变慢,建议按下面五步走,最后一步才轮到怀疑硬件。
五步排障清单
步骤 | 动作 | 关键检查点 |
第1步 | 核对驱动与固件 | 版本与操作系统、主板匹配;查阅厂商发布说明 |
第2步 | 检查中断与队列 | 用ethtool-l查看队列数、-g查看Ring深度;结合/proc/interrupts、/proc/softirqs确认中断与软中断分布均衡、已做CPU亲和 |
第3步 | 检查卸载与巨型帧 | 用ethtool-k确认校验和卸载、tso、gro已开启;按场景决定MTU |
第4步 | 打流验证 | 用iperf3做单流与多流对比,区分“单流上限”与“整卡上限” |
第5步 | 复检物理层 | 协商速率、光模块光功率、线缆与接口状态;最后再换硬件 |
为什么我们总想“换掉”,而不是“调好”?
换硬件是可见的、可汇报的、能立刻写进周报的;调软件是琐碎的、难量化的、要反复试错的。于是很多组织习惯用“买买买”替代“调调调”,买了新硬件,继续跑旧配置,浪费翻倍。
真正的浪费往往不是设备采购,而是“新设备跑着旧配置”的沉默损耗。技术管理里最贵的成本是认知,不是硬件。把“调好”作为第一步,把“换掉”作为最后一步,很多性能预算本可以不用花。
先调好,再换掉
下次网络变慢,先做五步排障,再谈换卡。硬件值得你为它掏钱的时候,是你已经确认软件与配置都没有问题之后。到那时,你花的每一分钱,都在为性能买单,而不是为习惯买单。