机房里有一类设备,看上去完全正常:指示灯亮,链路通,业务在跑。但它已经进入了“没人再为它写驱动”的阶段。
这类设备的麻烦不会立刻出现。它会在下一次系统升级、下一次内核更新、下一次安全补丁之后出现:新系统认不出它,或者认得出,但性能掉了一半。
设备的退休,很少由故障宣布。更多时候,是一行编译不过的驱动代码。
一、四层支持周期,本来就走不到一起
一条链路从下到上,至少四层各有各的时间表。
硬件本体——电容、风扇、结构件,行业经验值在八年左右;固件与驱动的维护,常见是五年上下;内核按公开计划推进:Linux6.12于2024年11月发布,官方计划支持到2028年12月,6.6与6.1到2027年12月;发行版看厂商计划,企业版常见的维护期是十年量级。
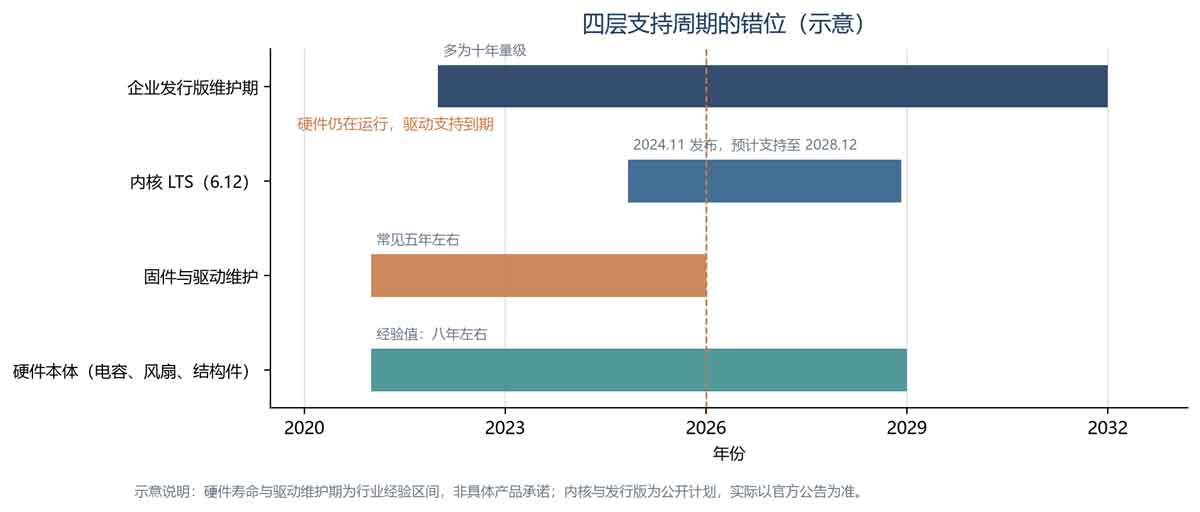
硬件、驱动、内核与发行版的支持周期错位
四层叠加的结果很明确:硬件的物理寿命,往往长于软件的支持寿命。设备不是坏掉那天退休的,而是“最后一次驱动更新”那天开始贬值的。
一条链路四层支持周期的量级
层级 | 谁在维护 | 周期量级 | 到期后的后果 |
硬件本体 | 设备厂商 | 八年左右(经验值) | 仍是可用资产,但缺少备件 |
固件与驱动 | 芯片或整卡厂商 | 五年上下(常见) | 新系统需自编译或无法加载 |
内核 | 社区(kernel.org) | LTS约两到六年(公开计划) | 旧驱动被移出主线,升级受阻 |
发行版 | 发行版厂商 | 十年量级(企业版) | 停更后需整体升级或迁移 |
注:硬件与驱动的周期为行业经验区间,不代表任何具体产品的承诺;内核支持期以kernel.org公布的计划为准。
二、驱动为什么会先“死”
三个原因,都和产品质量无关。
第一,上游在变。内核的接口、数据结构、电源管理框架一直在演进。一个五年前的驱动,放进新内核里编译不过、或者编过了行为不对,是常事。这不是谁的错误,是生态向前走的必然代价。
第二,维护意愿在变。芯片停产后,原厂把工程资源转到下一代产品,旧型号的驱动更新频率自然下降。等到某个安全漏洞需要修补时,才发现已经没有维护者了。
第三,认证在变。国产化项目要的是“有认证的适配”,不是“曾经能跑”。认证有版本,也有有效期,过期之后要重新测。
这也是为什么越来越多的集成商在投标时,要求供应商写清驱动的维护主体与响应时限。光润通的做法是把适配清单按客户的CPU与操作系统组合逐条确认,而不是给一份通用列表让对方自己对号——清单可以抄,对号要人做。老设备要不要延寿、延多久,往往就在这一次对号里定下来。
三、对企业意味着什么
采购时最容易被当成答案的,是那份“兼容列表”。它回答的是“曾经跑通过”,不回答“还能跑多久”。
更该问的是三个问题:驱动是谁维护的?进主线内核了吗?出问题谁定位?
第一问决定主动权在谁手里。用第三方主控芯片做卡,驱动节奏跟着芯片厂;自研芯片,才能自己决定什么时候给老平台补一次适配。
第二问决定升级成本。驱动在主线内核里,换发行版时不用重新编译;只在厂商私有的安装包里,每次升级都要重走一遍流程,测试成本会逐年累积。
第三问决定故障归属。网卡问题常常横跨主机、系统、网络三段,没人愿意认领的时候,能不能快速给出定位结论,比参数表重要。
四、几项可以对照核查的做法
光润通公开资料里有几项,是可以拿去逐条核对的,而不是形容词。
一是芯片自主。自研以太网控制器覆盖千兆到100G(G210、G225、G350、G710G2、G810系列),迭代节奏不受单一第三方芯片停产影响,整卡可做全国产化。
二是平台矩阵。CPU侧覆盖x86_64、ARMv8以及飞腾、鲲鹏、龙芯、申威、海光、兆芯;系统侧覆盖银河麒麟V10、统信UOSV20、中标麒麟、中科方德、凝思,以及CentOS、RHEL、Ubuntu、Debian;产品出厂前经过上万次平台联调测试。
三是认证记录。2026年7月,光润通通过NeoCertify认证,与银河麒麟系统实现全面适配,这是可以在官网查到时间点的公开信息。
四是驱动形态。驱动按标准Linux内核的方式提供,减少“每家一个私有包”的维护负担,也减少升级时的重复测试。
设备的生命周期管理,本质是把“支持期”当成一个采购参数,和价格、性能放在同一张表上比较。
把它写进合同,比把兼容列表贴进验收报告更有用——因为合同管的是第五年,验收报告只管第一天。